Circulou um post dizendo que "pesquisadores chineses" tinham assinado o atestado de óbito da programação. O print mostrava um paper com o título The End of Software Engineering. Eu abri o paper.
Circulou um post dizendo que "pesquisadores chineses" tinham assinado o atestado de óbito da programação. O print mostrava um paper com o título The End of Software Engineering.
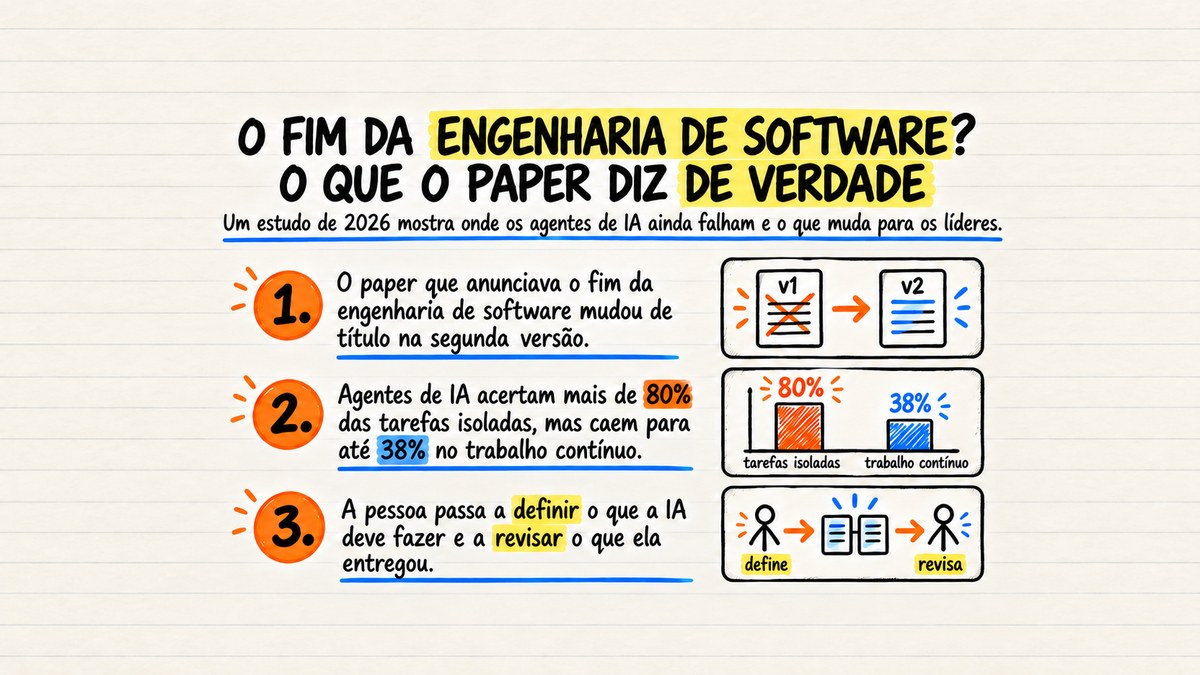
Eu abri o paper. Tem um autor só: Zhenfeng Cao, da Lingxi Intelligent Investment, em Shenzhen. O documento está no arXiv com o número 2606.05608. E o próprio autor já suavizou o título.
Na versão 1, de 4 de junho de 2026, o título era The End of Software Engineering: How AI Agents Are Fundamentally Restructuring the Software Paradigm. Na versão 2, de 10 de junho de 2026, passou a Agentic Software: How AI Agents Are Restructuring the Software Paradigm. O atestado de óbito sumiu. Sobrou a tese de que agentes estão reestruturando o que software é.
Para quem lidera empresa no Brasil, a pergunta que paga a conta é outra: o que muda no trabalho dos times, quem decide e quem audita.
O que o paper diz de fato
Cao parte de uma distinção simples. No software tradicional, o código carrega a lógica de decisão escrita de antemão. No que ele chama de software agentic, o agente é o software. A lógica de decisão nasce na hora, enquanto o modelo de linguagem raciocina, chama ferramentas, gera código e joga fora o que não precisa mais.
Ele descreve uma trajetória em três gerações de entrega: software licenciado, SaaS e o que chama de Agent-as-a-Service. Em cada etapa, a complexidade operacional foi saindo das mãos do usuário final. No salto agentic, sai também parte da complexidade de decisão.
Na seção 4.3, Cao redesenha o papel humano. O valor deixa de ser medir quem produz código correto mais rápido. O que passa a diferenciar o profissional, na lista dele, são quatro coisas:
- Articular a intenção com clareza e limites suficientes para o agente operar sem produzir resultado indesejado.
- Fazer a supervisão de arquitetura: como vários agentes se coordenam, que memória compartilham e onde o julgamento humano entra.
- Calibrar qualidade: definir o que é "bom" e montar critérios de avaliação que o próprio agente use para se corrigir.
- Governança ética: alinhar o comportamento do agente a valores, regra e expectativa da organização.
Na conclusão, ele escreve sem rodeio. A engenharia de software antiga não está acabando. Ela está crescendo. O profissional que ele descreve é um arquiteto de intenção. Alguém que dirige agentes em direção a resultados complexos.
O que o post viral exagerou
Três exageros merecem correção.
Primeiro, "pesquisadores chineses" no plural. O paper tem um autor. Ele trabalha numa empresa de investimento em Shenzhen. Isso não anula o texto. Muda o peso da manchete.
Segundo, "atestado de óbito da programação". O próprio Cao troca o título entre a v1 e a v2. Na conclusão da v2 ele escreve que o velho ofício não termina: ele se expande.
Terceiro, tratar o paper como prova de autonomia total já pronta. Na seção 5.2, Cao usa o benchmark que chama de EvoClaw (Deng et al., arXiv 2603.13428) e mostra a queda: desempenho acima de 80% em tarefas isoladas e no máximo 38% em evolução contínua de software, quando o erro se acumula ao longo do tempo. Na página atual desse mesmo identificador no arXiv, o título aparece como SWE-Milestone. O número que importa é o mesmo: em trabalho contínuo, o agente ainda erra bastante.
Agentes já resolvem pedaços úteis. Ainda falham quando a tarefa vira manutenção longa, com dívida técnica e contexto que cresce.
O que muda no trabalho dos times
Se a lógica de decisão nasce na hora, o gargalo do time muda de lugar.
Escrever e revisar código deixa de ser o único freio. O freio novo tem três peças: definir o pedido com limite, quebrar o trabalho em partes que um agente (ou um time de agentes) consiga executar, e auditar o resultado com critério.
Isso não vale só para engenharia. Vale para qualquer área em que o trabalho se parte em tarefas com começo, meio, fim e prova de pronto. Marketing pedindo criativo. Financeiro pedindo conciliação. RH pedindo roteiro de entrevista. Operações pedindo checklist de auditoria.
Cao cita, na seção 5.1, resultados do SWE-bench Verified. Lingma SWE-GPT 72B resolve 30,20% das issues avaliadas, perto dos 31,80% atribuídos ao GPT-4o no mesmo trecho. A página oficial do SWE-bench Verified descreve o conjunto como um subconjunto de 500 instâncias revisadas por humanos, feito em colaboração com a OpenAI, para avaliação mais confiável de agentes e modelos de código.
Ele também cita o piloto da LangChain (Kumar e Ramagopal, abril de 2026): em mais de 20 fluxos de debugging empresariais, o sistema coordenado de agentes reduziu em 93% o tempo até a causa raiz e economizou mais de 200 horas de engenharia num mês. O ganho, segundo o post, veio da orquestração, não de um agente isolado melhor.
Número de paper e de piloto não garante resultado no seu time. Serve para calibrar a expectativa. Há ganho real em tarefa bem delimitada. Há precipício quando a tarefa vira evolução contínua sem auditoria.
Três decisões práticas para líderes
1. Onde o trabalho se divide em tarefas independentes
Olhe o fluxo do seu time e marque o que tem critério de pronto claro, escopo fechado e teste já existente. Esses pedaços são candidatos a agente. O que depende de julgamento político, de exceção rara ou de contexto que ninguém documentou ainda fica com gente.
Pergunta operável: nesta semana, quais três tarefas do time têm entrada, saída e teste escritos numa página?
2. Quem audita e com qual critério
Sem critério, o agente acelera o erro. Defina quem aprova o que sai, em qual formato a prova aparece e o que acontece quando o resultado falha no teste.
No meu caso, a regra é simples: o agente prepara, eu aprovo, aí sai. Rascunho de texto, e-mail, post e mudança em produção passam por essa trava. Sem ok no texto exato, não publica.
Pergunta operável: para cada fluxo agentic, quem é a pessoa que assina o ok e qual é o checklist mínimo dessa assinatura?
3. Quanto custa
Custo aqui inclui a assinatura da ferramenta e mais três contas: tempo de quem escreve a intenção, tempo de quem audita, e o retrabalho quando um erro passa ou o contexto escorrega.
Cao, na seção 7.2, levanta a pergunta de cobrar por resultado (por issue resolvida, por feature entregue). Na sua empresa, comece mais baixo. Meça horas poupadas e horas gastas em correção na mesma planilha. Se a correção come o ganho, o fluxo ainda não está pronto para crescer.
Pergunta operável: no próximo piloto, qual é o teto de horas de auditoria que você aceita por entrega aceita?
Como eu trabalho com agentes (e por que nada sai sozinho)
Eu uso agentes no dia a dia. Eles leem ferramentas que eu já uso, preparam briefing, rascunho e pesquisa. Eu leio. Eu mudo o que precisa. Eu aprovo. Só então o material sai.
Essa divisão parece óbvia. É a parte que muita empresa pula. Liberar o agente para "fazer mais rápido" sem trava de aprovação troca fila de trabalho por fila de retrabalho.
Se você quiser ver o setup na prática, o guia "Como criar um assistente pessoal igual ao que eu uso" entra no ar em 5/11. Lá eu mostro a ordem de montagem e a regra de aprovação que eu não abro mão.
O que eu tiro do paper de Cao, lido ao lado do post viral, é isto. O trabalho humano está saindo de executar para definir a intenção, dividir o trabalho e auditar o resultado. Vale para software. Vale para o resto da empresa também.
Perguntas rápidas
O paper declara o fim da programação?
Não. A versão 1 usava The End of Software Engineering no título. A versão 2 trocou para Agentic Software. Na conclusão, Cao diz que a disciplina não termina: ela se expande.
Quem escreveu o paper?
Zhenfeng Cao, um autor, afiliado à Lingxi Intelligent Investment (Shenzhen) Development Co., Ltd. O documento público é o arXiv 2606.05608.
Agentes já substituem times de engenharia?
Não no sentido de autonomia contínua confiável. Cao reporta, via Deng et al. (arXiv 2603.13428), queda de desempenho de mais de 80% em tarefas isoladas para no máximo 38% em evolução contínua. Há ganho em pedaço bem delimitado. Há limite claro em manutenção longa.
O que um líder deve decidir primeiro?
Onde o trabalho se parte em tarefas independentes, quem audita com qual critério, e como o custo de auditoria entra na conta do piloto. Sem essas três decisões, ferramenta nova só acelera o caos.
Onde aprofundo isso com o meu time?
Na imersão de IA, no advisory ou numa palestra sob medida. O trabalho útil ali é montar a regra de intenção, divisão e auditoria no seu contexto, não virar aula de prompt.
Se o seu time já misturou agente com processo antigo e a fila só cresceu, me escreva. A conversa útil começa pela restrição do funil de trabalho, não pela ferramenta da moda.
Imersão de IA · Advisory · Palestra
Fontes
- Zhenfeng Cao, Agentic Software: How AI Agents Are Restructuring the Software Paradigm, arXiv:2606.05608v2 (10/06/2026). PDF.
- Zhenfeng Cao, v1 The End of Software Engineering: How AI Agents Are Fundamentally Restructuring the Software Paradigm, arXiv:2606.05608v1 (04/06/2026).
- SWE-bench Verified, página oficial (lida em 31/10/2026).
- Renuka Kumar e Prashanth Ramagopal, Agentic Engineering: How Swarms of AI Agents Are Redefining Software Engineering, LangChain Blog, 17/04/2026.
- Deng et al., arXiv:2603.13428 (citado por Cao como EvoClaw; título atual na página do arXiv: SWE-Milestone).
Quer transformar esta ideia em uma palestra, workshop ou advisory conectado ao desafio da sua empresa?