Destilação é uma forma de treinar um modelo de inteligência artificial usando respostas ou outros sinais produzidos por outro modelo. Eu penso nela como uma aula com exercícios: um modelo professor orienta o aprendizado de um modelo aluno, muitas vezes menor e mais barato de executar. Isso não transfere automaticamente tudo o que o professor sabe.
Destilação é uma forma de treinar um modelo de inteligência artificial usando respostas ou outros sinais produzidos por outro modelo. Eu penso nela como uma aula com exercícios: um modelo professor orienta o aprendizado de um modelo aluno, muitas vezes menor e mais barato de executar.
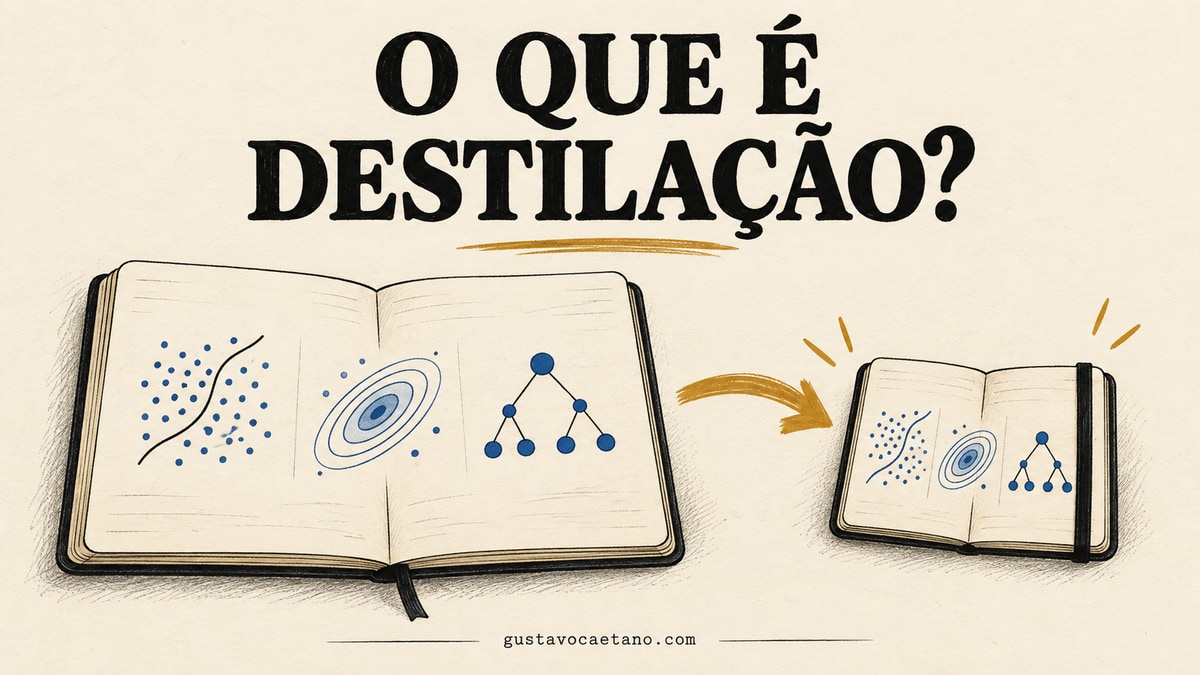
Isso não transfere automaticamente tudo o que o professor sabe. Minha decisão começaria por uma pergunta bem concreta: qual tarefa precisa continuar funcionando depois dessa troca?
Para uma empresa, a oportunidade está em repetir uma tarefa útil com menos recursos. Mas a conta precisa incluir preparação dos exemplos, treinamento, avaliação e manutenção. Uma resposta barata pode sair cara quando exige mais correção.
Em uma frase
Destilação de conhecimento, ou *knowledge distillation*, é o treinamento de um modelo para aprender comportamentos a partir de sinais fornecidos por outro modelo, com frequência buscando uma execução mais leve para tarefas definidas.
Um marco conhecido é o artigo Distilling the Knowledge in a Neural Network, de Geoffrey Hinton, Oriol Vinyals e Jeff Dean, publicado em março de 2015. Ele desenvolve pesquisas anteriores sobre levar o conhecimento de conjuntos de modelos para um modelo mais simples de usar. Portanto, a técnica é anterior à popularização dos chatbots atuais.
Como explicar com um caderno de exercícios?
Imagine uma pessoa aprendendo a separar mensagens de uma caixa de entrada. O professor mostra exemplos de pedidos, reclamações e avisos. O aluno pratica, compara suas respostas e ajusta a forma de classificar.
Essa metáfora não significa que a IA aprenda como uma pessoa. Há um processo de treinamento que modifica parâmetros, os valores numéricos que participam do funcionamento do modelo. A metáfora ajuda a visualizar a orientação. Ela deixa de funcionar se sugerir que o aluno herda a experiência inteira do professor.
Também não é preciso que todo professor seja gigantesco ou que todo aluno seja menor. Essa é uma configuração comum quando o objetivo é reduzir o custo de execução, não uma regra que define todas as formas de destilação.
Como a destilação funciona na prática?
Eu separaria o processo em quatro etapas para conversar com uma equipe técnica:
- Escolher a tarefa: definir entradas, saídas e erros que importam. Classificar mensagens é um escopo; resolver qualquer problema da empresa não é.
- Obter orientação: usar respostas, probabilidades ou outras representações do professor, conforme o método escolhido.
- Treinar o aluno: ajustar o modelo para aprender a partir desses sinais, eventualmente junto de exemplos com respostas conhecidas.
- Avaliar fora do treino: conferir o resultado em situações que não foram usadas para ensiná-lo.
O tutorial oficial do PyTorch mostra diferentes maneiras de orientar uma rede menor, incluindo probabilidades de saída e representações internas. É um exemplo de classificação de imagens, não uma demonstração de retorno financeiro para qualquer chatbot.
Nos modelos de linguagem, uma abordagem é gerar exemplos com o professor e usá-los para treinar o aluno. Outra pode oferecer orientação sobre respostas que o próprio aluno produziu. A documentação do Distillation Trainer da Hugging Face apresenta essa segunda abordagem. O ponto relevante para o gestor é que existem métodos diferentes; pedir apenas “um modelo destilado” ainda deixa muita decisão em aberto.
Onde isso aparece no dia a dia e na empresa?
Como exemplo cotidiano hipotético, pense num aplicativo que organiza fotos em algumas categorias. Um modelo mais exigente ajuda a treinar outro que caiba melhor no aparelho. A pessoa quer encontrar a foto; não precisa que o telefone execute o modelo mais pesado disponível para toda tarefa.
Na empresa, eu consideraria um piloto de triagem de mensagens. O objetivo seria sugerir se um pedido trata de entrega, cobrança ou cancelamento. A equipe continuaria responsável pela resposta ao cliente durante a avaliação.
O professor produziria sugestões para exemplos autorizados. Pessoas conhecedoras do processo revisariam o material antes de usá-lo no treinamento. Mensagens ambíguas, curtas ou com mais de um pedido precisariam aparecer na avaliação, porque são justamente as situações em que uma classificação bonita pode falhar.
Esse cenário é ilustrativo. Não estou relatando um teste meu, um cliente ou um resultado medido. A documentação do Amazon Bedrock oferece um exemplo atual de serviço que gera respostas com um professor e ajusta um aluno com esses dados, separando treino e validação. Isso mostra um caminho disponível; não prova que ele seja a melhor escolha para a sua operação.
Qual é a diferença para quantização, ajuste fino e RAG?
Eu faria esta comparação na reunião de decisão:
- Destilação: um modelo aprende com sinais de outro. A pergunta é: temos um comportamento útil para ensinar?
- Quantização: a representação numérica fica menos precisa. A pergunta é: podemos usar menos memória sem perder qualidade demais?
- Ajuste fino: o treinamento adapta os parâmetros do modelo. A pergunta é: quais exemplos e objetivos vão orientar essa adaptação?
- RAG: a aplicação busca informações para compor a entrada. A pergunta é: a resposta precisa consultar documentos atuais?
Ajuste fino, ou *fine-tuning*, pode ser parte de uma destilação. Os termos descrevem aspectos diferentes do processo e não precisam competir entre si.
A explicação sobre quantização aprofunda a redução da precisão numérica. Já o artigo sobre RAG mostra como a busca acrescenta informações à entrada da IA. RAG significa geração aumentada por recuperação. Treinar um aluno não substitui necessariamente essa consulta: um preço alterado hoje pode continuar exigindo uma fonte atual.
Quando vale investir e quando eu adiaria?
Eu olharia para a destilação quando existe uma tarefa frequente, relativamente estável, bem avaliada e cara o suficiente para justificar o esforço. Antes disso, compararia com um modelo pequeno já disponível, sem treinamento adicional.
Esse último passo evita um projeto desnecessário. Se a alternativa pronta já atende à exigência de qualidade, talvez o trabalho de destilar acrescente pouco valor.
Considere uma conta inteiramente hipotética, criada apenas para explicar a decisão. Preparar dados, treinar e avaliar custa R$ 12 mil. A execução passa de R$ 4 mil para R$ 2 mil por mês, mas a revisão e a manutenção acrescentam R$ 800 mensais. A economia líquida fica em R$ 1.200 por mês; recuperar os R$ 12 mil levaria dez meses, mantidas essas condições.
Se a tarefa mudar profundamente em três meses, essa conta perde força. Se a qualidade cair e exigir mais trabalho humano, o prazo aumenta. Esses valores não são preços de fornecedor nem estimativas de mercado.
Eu adiaria a adoção quando a empresa ainda não consegue explicar o que é uma boa resposta, quando o volume é pequeno ou quando o processo muda toda semana. Nesses casos, definir a tarefa pode render mais do que treinar outro modelo.
Minha análise: o que eu mediria antes de trocar?
Minha proposta é comparar três participantes na mesma avaliação: o modelo pequeno original, o aluno depois do treinamento e o professor. Sem o primeiro, a empresa pode atribuir à destilação um ganho que já existia numa opção pronta. Sem o professor, perde a referência do comportamento que tentou ensinar.
Eu reservaria casos que não entraram no treino e separaria situações comuns de exceções importantes. A média geral não deveria esconder, por exemplo, pedidos de cancelamento encaminhados para a fila errada.
Mediria acerto por categoria, tempo de resposta e custo por tarefa aceita. Também registraria quantos casos precisaram de correção humana e quanto trabalho isso consumiu. A passagem para produção dependeria de limites definidos antes de ver o placar, com um responsável por interromper o uso se o desempenho piorar.
Há ainda uma pergunta simples: quem vai atualizar o aluno quando o processo mudar? Se ninguém assume esse trabalho, a economia apresentada na reunião está incompleta.
Para mim, a melhor aplicação da destilação começa com uma competência bem delimitada. Ensinar menos coisas, com critérios claros, torna a avaliação mais honesta. A promessa de “toda a inteligência por uma fração do preço” exige uma prova muito maior.
Perguntas rápidas
Destilação é copiar um modelo inteiro?
Não. O aluno é treinado com sinais do professor e pode aprender parte de seu comportamento. Isso não garante a reprodução de todas as capacidades, nem transfere automaticamente seus parâmetros. A qualidade precisa ser verificada nas tarefas que motivaram o treinamento, incluindo casos difíceis e situações diferentes dos exemplos usados no treino.
Um modelo destilado sempre custa menos?
Não necessariamente no custo total do projeto. Um aluno menor pode exigir menos recursos para responder, mas há gastos com dados, treinamento, avaliação e manutenção. Eu compararia a economia na execução com esses custos e com o trabalho humano necessário para corrigir erros antes de afirmar que houve ganho financeiro.
Destilação elimina erros e respostas inventadas?
Não. O aluno pode aprender erros presentes nos exemplos do professor e também produzir falhas próprias. Revisar os dados ajuda, mas não substitui testes separados. A avaliação deve usar critérios externos de correção; apenas concordar com o professor não basta para demonstrar que uma resposta está certa.
Minha empresa precisa treinar um modelo para começar com IA?
Não. Eu começaria avaliando modelos prontos e um processo pequeno. Destilação passa a fazer sentido quando existe uma tarefa recorrente, critérios de qualidade claros e uma expectativa de economia que compense o investimento. Também é necessário verificar as condições de uso dos modelos e a autorização para os dados escolhidos.
Fontes e data de corte
Consultei em 23 de setembro de 2026 o artigo de Hinton, Vinyals e Dean, o tutorial do PyTorch e as documentações de Hugging Face e Amazon Bedrock vinculadas acima. Os exemplos de fotos, atendimento e custos são hipotéticos. Não executei treinamento para este artigo nem estou apresentando um benchmark próprio.
Essa é uma conversa que eu levaria para a liderança antes de aprovar mais um projeto de IA: qual trabalho precisa melhorar e como saberemos que a conta fechou? Para discutir essas escolhas no seu evento, conheça minhas palestras sobre inteligência artificial. Para acompanhar outras análises, assine minha newsletter no Substack.
Quer transformar esta ideia em uma palestra, workshop ou advisory conectado ao desafio da sua empresa?