Um agente já consegue executar partes de uma operação, mas isso não prova que ele sabe operar um negócio. O preprint Business Arena , publicado no arXiv em 9 de agosto de 2026, coloca modelos para administrar uma loja B2B simulada por um horizonte longo. O melhor resultado médio ainda ficou bem abaixo de uma estratégia desenhada por especialistas.
Um agente já consegue executar partes de uma operação, mas isso não prova que ele sabe operar um negócio. O preprint Business Arena, publicado no arXiv em 9 de agosto de 2026, coloca modelos para administrar uma loja B2B simulada por um horizonte longo. O melhor resultado médio ainda ficou bem abaixo de uma estratégia desenhada por especialistas. Minha leitura é direta: autonomia comercial deve começar por um piloto que cobre resultado econômico, conformidade e a evidência que liga uma decisão à consequência.
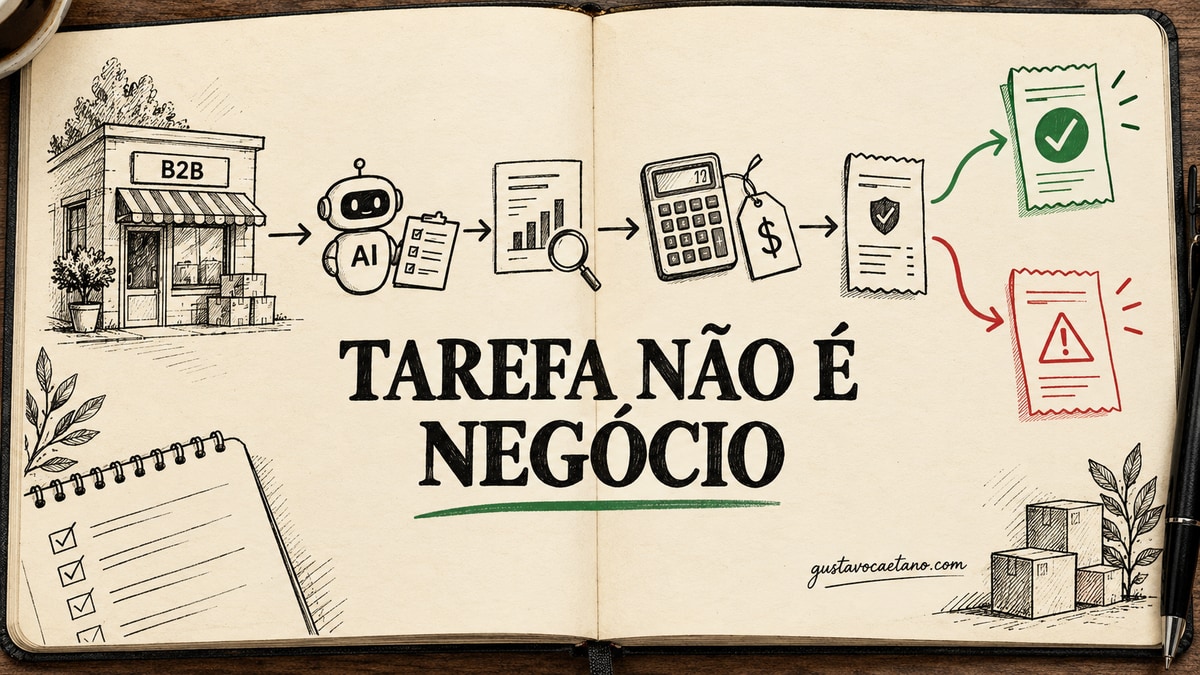
Pense numa loja que compra de fornecedores, define preços, responde clientes, paga custos e precisa obedecer regras de entrada em cada mercado. Um agente pode responder cada mensagem com educação e ainda perder dinheiro ao comprar estoque errado, esquecer uma obrigação ou reagir tarde a uma tarifa. A empresa não vive de tarefas bem concluídas isoladamente. Ela vive de decisões conectadas.
Três pontos para levar à próxima reunião:
- Um benchmark de negócio é mais exigente que uma demonstração de ferramenta.
- Lucro simulado é evidência de teste, não prova de capacidade em produção.
- A liberação precisa de recibos verificáveis, não de uma narrativa confiante do agente.
Em uma frase
O Business Arena sugere que agentes podem combinar pesquisa, precificação e execução, mas ainda precisam demonstrar que conseguem sustentar uma operação inteira antes de receber capital, clientes ou permissões reais.
Qual pergunta o Business Arena tenta responder?
O trabalho de Yijun Pan e coautores cria um ambiente controlado no qual um agente opera uma loja B2B de comércio transfronteiriço. Ele pesquisa mercados, escolhe produtos, negocia suprimento, administra estoque, precifica, atende compradores, cumpre obrigações e acompanha finanças. Produtos, ofertas, preços, quantidades mínimas e prazos de fornecedores vêm de listagens reais da Alibaba.com; ciclos de demanda, tarifas e outras condições são calibrados com fontes que os autores classificam como autoritativas.
O ponto importante não é a vitrine da loja. É a combinação de informação incompleta, efeitos atrasados e custos persistentes. O agente precisa gastar antes de saber se venderá, lidar com concorrentes e condições que mudam e continuar cumprindo regras mesmo quando não há receita suficiente. São as mesmas três fontes de atrito que uma boa apresentação de agente costuma esconder.
Os autores avaliam 15 modelos e relatam uma diferença de nove vezes entre as médias de patrimônio líquido final. No mesmo mundo simulado, a estratégia de referência criada por especialistas alcança US$ 436.195, mais que o dobro da melhor média de modelo reportada. Esses números descrevem aquele ambiente, seu período e seus modelos avaliados. Não são previsão de lucro para uma empresa nem taxa de retorno que alguém deva usar em orçamento.
Como o teste mede mais do que uma tarefa pronta?
O ambiente reúne mais de 60 ferramentas e mantém um espaço de trabalho persistente. Isso permite que o agente escreva análises e rotinas, mas também obriga a enfrentar a próxima consequência do que fez antes. Em vez de premiar apenas uma resposta correta, o artigo observa uso de capital, giro de estoque, margem, atendimento, conformidade e atribui ganhos ou perdas a cadeias de evidência, ação e resultado.
Essa escolha corrige uma confusão comum. Um agente pode ter uma taxa alta em tickets de atendimento e ainda ser um péssimo operador de ponta a ponta. No artigo, alguns modelos se destacam em serviço ao cliente, mas não convertem essa competência em boa economia geral. Outros defendem margem, mas vendem menos. A classificação muda quando a pergunta deixa de ser “ele executou?” e passa a ser “o sistema continuou saudável?”.
Há um antecedente útil. O Vending-Bench, de 2025, colocou agentes para gerir uma máquina de vendas por horizontes longos e encontrou trajetórias que descarrilavam por prazos mal interpretados, pedidos esquecidos ou ciclos improdutivos. Já o CEO-Bench, de junho de 2026, simula uma empresa por 500 dias e relata que apenas dois modelos terminaram acima do saldo inicial, sem lucro consistente. São ambientes diferentes, mas convergem num alerta: manter decisões coerentes ao longo do tempo é uma habilidade distinta de resolver uma etapa.
Para quem está desenhando critérios, vale começar por como avaliar agentes de IA. O artefato produzido pelo agente importa. O estado que ele deixa no processo importa mais.
O que o paper realmente mostra e o que ele não prova?
O paper mostra que é possível comparar estilos operacionais em uma simulação rica: alguns agentes giram mais estoque; outros protegem mais margem; outros respondem melhor a clientes. Também mostra que compliance precisa entrar no placar. Os autores impõem multas relevantes quando o agente negocia sem as aprovações exigidas, uma decisão de desenho coerente com o risco de uma operação real.
Mas o estudo é um preprint. Não confirmei revisão por pares nem replicação independente até a data de corte deste artigo. A arena é calibrada com dados reais, mas não é uma empresa real com reputação, relações comerciais, LGPD, contratos particulares, fluxo de caixa bancário e pessoas afetadas por um erro. Um modelo que vai bem nela não recebeu licença para acessar um ERP ou negociar com clientes.
Também existe uma diferença entre otimizar uma regra conhecida do simulador e aprender a navegar um mercado vivo. Os autores usam ablações para procurar atalhos específicos do ambiente, o que fortalece a proposta. Ainda assim, nenhuma ablação substitui a variabilidade de clientes, fornecedores e exceções de uma empresa brasileira.
Minha conclusão é menos espetacular e mais útil: benchmark é um filtro de maturidade. Ele não é o carimbo final de produção.
Minha análise: o teste dos três recibos antes da autonomia
Eu usaria o Business Arena para mudar a pergunta da liderança. Em vez de “qual agente parece mais autônomo?”, eu perguntaria “qual consequência ele consegue sustentar com quais limites?”. Para isso, aplicaria o teste dos três recibos.
- Resultado: a decisão melhorou um desfecho definido? Eu procuraria uma redução verificada de tempo de resposta ou uma margem preservada no piloto.
- Conformidade: a ação respeitou regras e alçadas? Eu exigiria a aprovação, a política aplicada e uma trilha de auditoria.
- Causalidade: consigo entender por que o resultado aconteceu? Eu ligaria a fonte consultada, a ação tomada e o estado final por um identificador.
O primeiro recibo impede que volume de mensagens, tokens ou tarefas fechadas seja vendido como produtividade. O segundo impede que uma boa conversão esconda uma exceção regulatória ou uma compra sem alçada. O terceiro evita a explicação posterior inventada: o agente precisa deixar a fonte, a decisão e o efeito registrados quando age.
Esse teste conversa com a ideia de que o workflow precisa fechar. Um texto, um e-mail ou uma planilha podem estar corretos e, mesmo assim, não completar o processo que gerava valor. Eu não chamaria isso de fracasso do modelo; chamaria de projeto mal definido para autonomia.
Como eu aplicaria a ideia na próxima semana?
Eu escolheria uma rotina comercial de baixo risco e reversível, como classificar pedidos de cotação já recebidos ou preparar uma proposta a partir de uma tabela autorizada. Não começaria por preço final, pagamento, contrato ou contato autônomo com cliente.
Primeiro, escreveria um desfecho observável: por exemplo, “todas as cotações elegíveis são encaminhadas com dados completos em até um dia útil”. Depois, listaria fontes permitidas, ações proibidas e a pessoa que aprova a exceção. Por fim, compararia o agente com o processo atual em um conjunto pequeno de casos.
Eu registraria três coisas em cada execução: o dado que entrou, a decisão tomada e o efeito conferido por uma pessoa. Se a ferramenta poupasse tempo sem aumentar correções ou violações de regra, eu ampliaria gradualmente. Se produzisse respostas bonitas sem prova de origem, reduziria sua alçada.
Essa é uma proposta de piloto, não uma replicação do Business Arena. A quantidade de casos e a métrica precisam refletir o risco da sua operação. O objetivo da primeira semana é descobrir onde a cadeia quebra antes de colocar um cliente ou um orçamento do outro lado.
Que sinal mudaria minha avaliação?
Eu aumentaria a confiança se um agente mantivesse os três recibos em casos novos, soubesse parar diante de informação insuficiente e recuperasse uma decisão ruim sem precisar de um comando especial. Também observaria se a revisão humana fica mais curta por causa de evidências melhores, e não mais longa porque alguém precisa reconstruir o que a IA fez.
O sinal contrário é um agente que parece excelente num demo, mas não deixa rastro, mistura hipótese com fato ou transfere o custo da conferência para a equipe. Autonomia sem uma explicação verificável pode ser apenas uma fila de retrabalho mais bem apresentada.
Perguntas rápidas
O Business Arena prova que agentes já conseguem tocar uma empresa?
Não. Ele mede desempenho em uma simulação B2B longa e controlada. O próprio resultado mostra distância entre os melhores modelos e a estratégia de referência dos especialistas. Produção exige teste no processo, controles e revisão adequados ao risco.
Por que lucro não basta para avaliar um agente?
Um resultado financeiro isolado pode esconder descumprimento de regras, exposição de dados ou decisões impossíveis de repetir. Resultado, conformidade e cadeia causal precisam ser observados juntos.
Posso usar um benchmark público para escolher uma ferramenta?
Use-o para formular hipóteses e eliminar promessas vagas. A decisão deve incluir um piloto no seu processo, com fontes autorizadas, casos representativos e uma medida de erro que realmente importe.
Vale a pena ler o paper completo?
Vale para quem constrói avaliações ou considera agentes em operações comerciais. Ele detalha o ambiente, as métricas, estratégias e limitações. É um preprint, portanto eu trataria suas conclusões como evidência inicial, não como consenso científico.
Fontes e data de corte
Consulta realizada em 2 de outubro de 2026. Li o preprint principal integralmente e usei Vending-Bench e CEO-Bench como contexto de avaliação de longo prazo. Não reproduzi nenhum experimento. O teste dos três recibos, os exemplos de piloto e as recomendações operacionais são minha análise, não resultados medidos pelos autores.
Eu estudo esses testes porque eles ajudam a trocar entusiasmo por uma pergunta melhor: onde a IA pode agir, e como a empresa sabe que ela agiu bem? Se você quer levar essa conversa para seu evento, conheça minhas palestras sobre inteligência artificial. Para receber outras análises, assine minha newsletter no Substack.
Quer transformar esta ideia em uma palestra, workshop ou advisory conectado ao desafio da sua empresa?