Um agente pode montar uma aprovação, preencher uma cláusula e encaminhar um contrato. Isso não significa que ele criou um processo confiável. A pesquisa publicada pela OpenAI com a plataforma de contratos Ironclad, em 6 de outubro de 2026, mostra uma direção mais útil: agentes profissionais precisam ser medidos por critérios verificáveis, incluindo as exceções, e não pela fluidez da demonstração.
Um agente pode montar uma aprovação, preencher uma cláusula e encaminhar um contrato. Isso não significa que ele criou um processo confiável. A pesquisa publicada pela OpenAI com a plataforma de contratos Ironclad, em 6 de outubro de 2026, mostra uma direção mais útil: agentes profissionais precisam ser medidos por critérios verificáveis, incluindo as exceções, e não pela fluidez da demonstração.
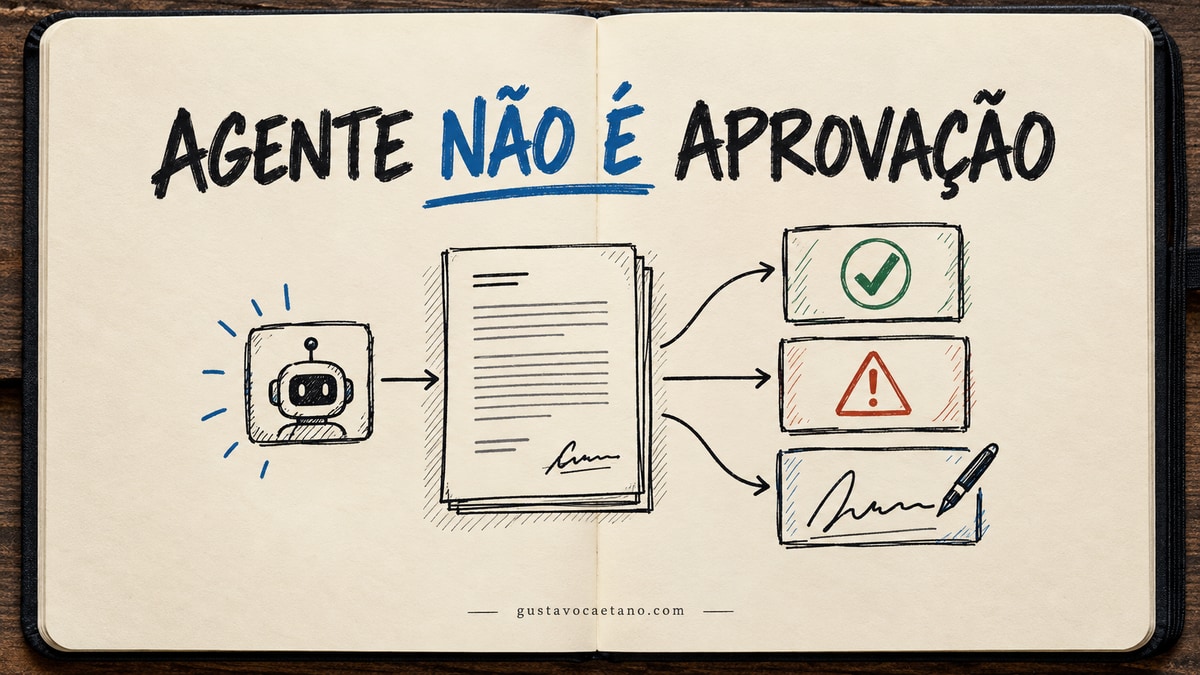
Eu vejo essa diferença sempre que uma empresa tenta automatizar algo que parece burocrático. Um fluxo de compra de software pode ter uma regra simples: acima de certo valor, Finanças aprova. Só que o trabalho real também envolve termos não padronizados, jurisdição, Segurança, urgência e quem responde quando a regra falha. O agente não está apenas digitando. Ele está atravessando uma cadeia de decisões.
Em uma frase
A colaboração OpenAI-Ironclad sugere que agentes em contratos devem ser liberados somente quando passam por critérios explícitos, casos de exceção ensaiados e uma atribuição humana clara do resultado final.
Qual pergunta a pesquisa tenta responder?
O artigo Advancing computer use with Ironclad descreve uma colaboração para transformar trabalho contratual em tarefas de treinamento e avaliação. A pergunta não é se um modelo consegue redigir uma cláusula isolada. É se ele consegue configurar e verificar um fluxo que continua correto quando as condições mudam.
As equipes selecionaram 11 tarefas de operações jurídicas, comerciais e de compras. Entre elas estavam montar acordos de confidencialidade, configurar processos de aprovação para compras e atualizar uma cláusula reutilizável conforme a jurisdição escolhida. Cada tarefa tinha de 8 a 50 critérios. Isso importa porque “o formulário apareceu” não é um critério suficiente quando a regra relevante pode estar no caminho que o agente não percorreu.
Segundo a OpenAI, o GPT-6 Astra alcançou média de 55,0% nessa avaliação, contra 41,6% do GPT-5.6 Sol, enquanto a estimativa de tempo por tentativa caiu de 37,0 para 19,2 minutos. Esses números são da avaliação dos próprios autores, em 11 tarefas, com configurações de raciocínio diferentes para cada modelo. Eles não medem economia de horas de um cliente, não representam todos os fluxos da Ironclad e não devem virar promessa de produtividade para qualquer empresa.
Quem publicou e qual é a força da evidência?
O texto é uma publicação corporativa da OpenAI em parceria com a Ironclad, não um estudo revisado por pares. Essa origem ajuda a entender o ambiente e os critérios, mas também pede cuidado: as duas empresas têm interesse legítimo em mostrar que a abordagem é útil. Até 16 de outubro de 2026, eu não encontrei uma replicação independente do conjunto de 11 tarefas.
Há pontos metodológicos que fortalecem o relato. A OpenAI informa que as tarefas de treino foram sintéticas e baseadas em contratos públicos da base EDGAR, filtrados para retirar dados pessoais. O texto também afirma que não usou contratos internos da OpenAI, nem dados ou contratos privados de clientes da Ironclad. Ainda assim, o resultado é evidência de capacidade numa avaliação desenhada com a parceira, não uma garantia de resultado numa empresa brasileira, com políticas, integrações e responsabilidades próprias.
Como comparação, o NIST AI Risk Management Framework propõe incorporar confiabilidade ao desenho, desenvolvimento, uso e avaliação de sistemas de IA. O NIST não valida a pesquisa da OpenAI. Ele oferece uma lente independente: uma avaliação boa não encerra o trabalho; ela vira parte de como a organização governa risco ao longo do uso.
Qual é o argumento central?
Eu reconstruo o argumento em três partes. Primeiro, conhecimento de domínio precisa entrar na avaliação. Quem opera contratos sabe quais regras parecem pequenas, mas travam uma compra, expõem dado ou criam uma obrigação indevida. Segundo, sucesso precisa ser observável em vários pontos do fluxo. O agente deve configurar o limite de aprovação e também provar que solicitações acima e abaixo dele seguem rotas diferentes. Terceiro, o ambiente de prática importa. Um agente só pode errar com segurança se existe um espaço controlado, dados autorizados e uma forma de conferir a saída.
Essa visão combina com o que a própria OpenAI encontrou no relatório sobre computação científica com agentes: pedidos bem delimitados avançam rápido, mas a validação de bordas e diferenças sutis continua exigindo pessoas. Em contratos, a borda não é detalhe. É onde uma alçada incomum, uma exceção comercial ou uma cláusula de privacidade muda o risco inteiro.
Pense numa catraca de prédio. Ela funciona quando reconhece quem pode entrar, mas a operação segura também precisa saber lidar com visitante, crachá perdido, emergência e registro de acesso. Um agente contratual é parecido. Acertar o caso padrão é necessário; saber quando parar, encaminhar e deixar rastro é o que torna o processo utilizável.
O que a pesquisa não prova?
Ela não prova que um agente pode assinar contrato, interpretar legislação, dispensar advogado ou operar sem revisão em decisões de alto impacto. Também não prova que 55,0% de média é suficiente para uso autônomo. Pelo contrário: uma média deixa claro que alguns critérios ficaram sem atendimento. Em fluxos com obrigações legais ou financeiras, um critério omitido pode valer mais que várias etapas feitas corretamente.
O tempo divulgado é outra limitação importante. São estimativas de tentativa simulada, baseadas em premissas de processamento e geração do modelo. Não é o tempo de ciclo de uma empresa, que inclui fila, sistema legado, revisão, conversa com fornecedor e correção. Eu não transformaria esse número em business case antes de medir o processo atual.
Por fim, o estudo não mostra como o sistema se comporta diante de incentivos adversariais. Um fornecedor pode pressionar prazo; uma área interna pode tentar contornar uma política; alguém pode inserir informação incompleta. Esses são precisamente os casos que um piloto precisa trazer para dentro da avaliação.
Minha análise: o teste CEA antes de delegar
Minha contribuição é o teste CEA: critério explícito, exceção ensaiada e atribuição final. Não é uma métrica da OpenAI ou da Ironclad. É a forma como eu traduziria o estudo para uma equipe que pretende testar um agente.
- Critério explícito: transforme cada regra importante em algo verificável. “Rota correta de aprovação”, “cláusula adequada à jurisdição” e “registro criado no sistema” são melhores que “contrato resolvido”.
- Exceção ensaiada: crie casos de teste com limite de valor, prazo incomum, termo fora do padrão, dado sensível e informação faltante. Se o agente só funciona no caminho limpo, ele ainda não está pronto para o processo real.
- Atribuição final: defina quem lê o resultado, quem tem poder de exceção e onde fica a evidência. Automação sem responsável é apenas uma decisão sem dono tomada mais depressa.
Esse teste complementa o que escrevi sobre como avaliar agentes de IA e como controlar agentes de IA na empresa. Eu não perguntaria primeiro “qual modelo é melhor?”. Perguntaria “quais critérios não podem falhar, onde o agente deve escalar e quem confirma o estado final?”.
Como aplicar a ideia na próxima semana?
Escolha um fluxo reversível, como preparar um acordo de confidencialidade padronizado ou classificar uma solicitação de compra para revisão humana. Antes de ativar qualquer ação externa, separe dez a vinte casos históricos sem dados sensíveis. Inclua cinco casos comuns e pelo menos cinco com alguma exceção documentada.
Escreva os critérios de aceitação antes de pedir ao agente para trabalhar. Por exemplo: a solicitação acima do limite foi encaminhada para Finanças? A cláusula reflete a jurisdição? A exceção foi sinalizada em vez de escondida? A pessoa revisora consegue entender por que o agente escolheu aquela rota?
Depois compare a saída com o histórico humano e conte o tempo de revisão, não apenas o tempo de geração. Continue o piloto se o agente reduz preparação sem aumentar correção, risco ou exceção invisível. Pare se a equipe não consegue explicar o que ele fez ou se o retrabalho engole a velocidade inicial.
Perguntas rápidas
A pesquisa prova que agentes já podem fazer contratos sozinhos?
Não. Ela relata progresso em 11 tarefas de pesquisa com critérios definidos. Não demonstra autonomia segura para contratos reais, assinatura ou aconselhamento jurídico.
Por que a média de 55,0% não basta para uma decisão?
Porque a média esconde quais critérios falharam. Em operações contratuais, uma regra de alçada, privacidade ou jurisdição pode ser mais importante do que várias etapas administrativas corretas.
O que deve entrar no primeiro piloto?
Um processo de baixo risco, casos históricos autorizados, critérios verificáveis, exceções preparadas e revisão humana com responsável nomeado.
Esse método vale fora da área jurídica?
Sim. Compras, atendimento, operações e finanças também têm regras, exceções e estados finais que precisam de critério, teste e atribuição antes de uma ação externa.
Fontes e data de corte
Dados conferidos em 16 de outubro de 2026. Li a publicação original Advancing computer use with Ironclad, da OpenAI, de 6 de outubro de 2026, e o relatório Scientific computing in the age of agentic AI para contexto sobre validação e manutenção. Consultei também o AI Risk Management Framework do NIST. O teste CEA e as recomendações de piloto são minha análise; não são conclusões medidas ou endossadas por essas organizações.
Eu gosto dessa pesquisa porque ela troca a pergunta vaga “o agente parece inteligente?” por uma pergunta de operação: “ele cumpre os critérios que protegem a decisão?”. Se você quer levar essa conversa para líderes e equipes, conheça minhas palestras sobre inteligência artificial. Para receber outras análises, assine minha newsletter no Substack.
Quer transformar esta ideia em uma palestra, workshop ou advisory conectado ao desafio da sua empresa?